- Algeria
- Bahamas
- Bahrain
- Belarus
- Belgium
- Belize
- Benin
- Bermuda
- Bhutan
- Bolivia
- Bonaire, Sint Eustatius, and Saba
- Botswana
- Bouvet Island
- Brazil
- British Indian Ocean Territory
- British Virgin Islands
- Brunei
- Bulgaria
- Burkina Faso
- Burundi
- Cambodia
- Cameroon
- Canada
- Cape Verde
- Cayman Islands
- Central African Republic
- Chad
- Chile
- China
- Christmas Island
- Cocos [Keeling] Islands
- Colombia
- Comoros
- Cook Islands
- Costa Rica
- Croatia
- Cuba
- Curaçao
- Cyprus
- Czech Republic
- Congo - Kinshasa
- Denmark
- Djibouti
- Dominica
- Dominican Republic
- Timor-Leste
- Ecuador
- Egypt
- El Salvador
- Equatorial Guinea
- Eritrea
- Estonia
- Ethiopia
- Falkland Islands
- Faroe Islands
- Fiji
- Finland
- France
- French Guiana
- French Polynesia
- French Southern Territories
- Gabon
- Gambia
- Georgia
- Germany
- Ghana
- Gibraltar
- Greece
- Greenland
- Grenada
- Guadeloupe
- Guam
- Guatemala
- Guernsey
- Guinea
- Guinea-Bissau
- Guyana
- Haiti
- Heard Island and McDonald Islands
- Honduras
- Hong Kong SAR China
- Hungary
- Iceland
- India
- Indonesia
- Iran
- Iraq
- Ireland
- Isle of Man
- Israel
- Italy
- Côte d’Ivoire
- Jamaica
- Japan
- Jersey
- Jordan
- Kazakhstan
- Kenya
- Kiribati
- Kosovo
- Kuwait
- Kyrgyzstan
- Laos
- Latvia
- Lebanon
- Lesotho
- Liberia
- Libya
- Liechtenstein
- Lithuania
- Luxembourg
- Macau SAR China
- Macedonia
- Madagascar
- Malawi
- Malaysia
- Maldives
- Mali
- Malta
- Marshall Islands
- Martinique
- Mauritania
- Mauritius
- Mayotte
- Mexico
- Micronesia
- Moldova
- Monaco
- Mongolia
- Montenegro
- Montserrat
- Morocco
- Mozambique
- Myanmar [Burma]
- Namibia
- Nauru
- Nepal
- Netherlands
- New Caledonia
- New Zealand
- Nicaragua
- Niger
- Nigeria
- Niue
- Norfolk Island
- North Korea
- Northern Mariana Islands
- Norway
- Oman
- Pakistan
- Palau
- Palestinian Territories
- Panama
- Papua New Guinea
- Paraguay
- Peru
- Philippines
- Pitcairn Islands
- Poland
- Portugal
- Puerto Rico
- Qatar
- Congo - Brazzaville
- Réunion
- Romania
- Russia
- Rwanda
- Saint Barthélemy
- Saint Helena
- Saint Kitts and Nevis
- Saint Lucia
- Saint Martin
- Saint Pierre and Miquelon
- Saint Vincent and the Grenadines
- Samoa
- San Marino
- São Tomé and Príncipe
- Saudi Arabia
- Senegal
- Serbia
- Serbia and Montenegro
- Seychelles
- Sierra Leone
- Singapore
- Sint Maarten
- Slovakia
- Slovenia
- Solomon Islands
- Somalia
- South Africa
- South Georgia and the South Sandwich Islands
- South Korea
- South Sudan
- Spain
- Sri Lanka
- Sudan
- Suriname
- Svalbard and Jan Mayen
- Swaziland
- Sweden
- Switzerland
- Syria
- Taiwan
- Tajikistan
- Tanzania
- Thailand
- Togo
- Tokelau
- Tonga
- Trinidad and Tobago
- Tunisia
- Turkey
- Turkmenistan
- Turks and Caicos Islands
- Tuvalu
- U.S. Virgin Islands
- Uganda
- Ukraine
- United Kingdom
- United States
- U.S. Minor Outlying Islands
- Uruguay
- Uzbekistan
- Vanuatu
- Vatican City
- Venezuela
- Vietnam
- Wallis and Futuna
- Western Sahara
- Yemen
- Zambia
- Zimbabwe
 by Ts Hasnan
- 06, Oct 2026
Google Perkenal Latihan AI dengan Privasi yang Boleh Diaudit: Apa yang Berubah?
Pada 2 Oktober 2026, Google Research mengumumkan sistem pembelajaran bersekutu yang menggunakan Trusted Execution Environments (TEE), iaitu persekitaran pengkomputeran terlindung. Menurut Google, pendekatan ini membolehkan pihak luar memeriksa jaminan privasi sambil memindahkan sebahagian pengiraan latihan AI ke pelayan.
Bagi pembaca IT Malaysia, perkembangan ini membuka perbincangan berguna tentang bukti di sebalik janji melindungi data. Lokasi pemprosesan sahaja belum menjawab siapa boleh mengakses maklumat, untuk tujuan apa dan bagaimana kawalannya diperiksa.
Perubahan yang diumumkan Google
Google menyatakan Gboard sudah menggunakan sistem tersebut untuk model ramalan perkataan seterusnya dalam bahasa Inggeris dan Jepun. Syarikat itu melaporkan peningkatan ketepatan serta latihan lebih pantas, tetapi pengumuman ini tidak mengesahkan pelaksanaan khusus untuk Bahasa Malaysia.
Graf perbandingan yang diterbitkan melibatkan latihan model bahasa Inggeris sebanyak 5,000 pusingan dengan kumpulan 6,500 peranti. Hasil tersebut perlu dibaca mengikut skop eksperimen itu; ia bukan bukti bahawa setiap bahasa, aplikasi atau jenis telefon akan memperoleh manfaat sama.
Sumber: Toward provably private learning from federated data — Google Research.
Bagaimana data sampai ke pelayan
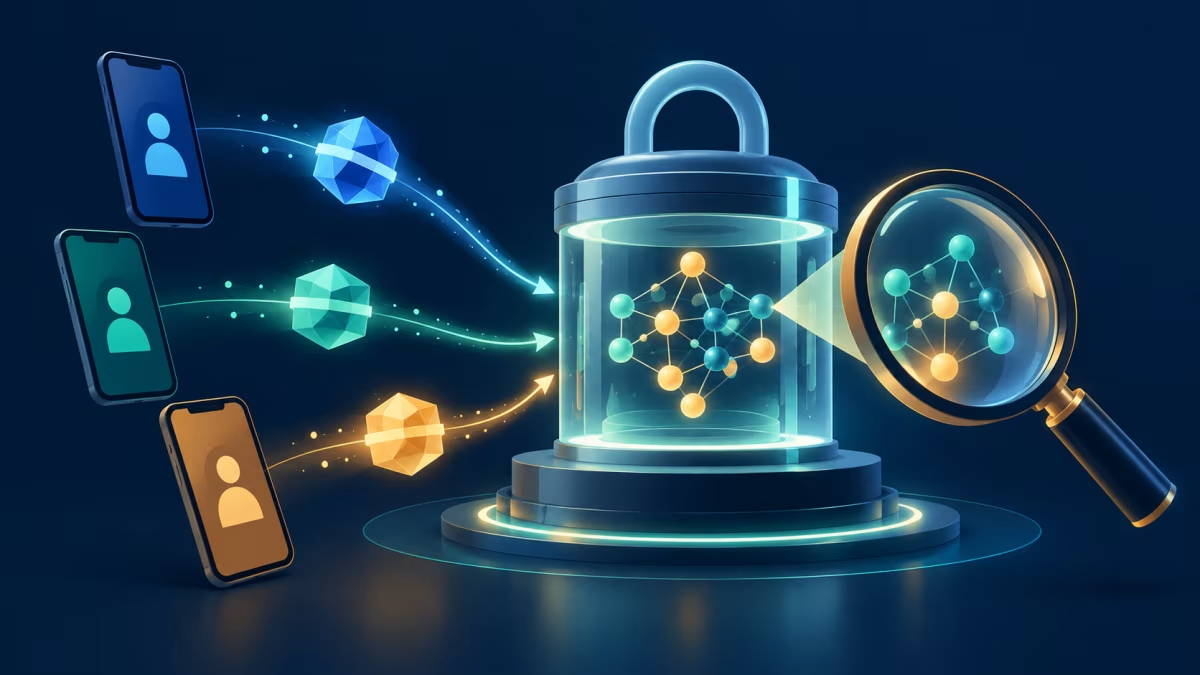
Kertas penyelidikan pasukan itu menerangkan bahawa peranti memuat naik data yang telah disulitkan. Data tersebut terikat secara kriptografi kepada dasar yang mengehadkan program Python yang boleh memprosesnya dalam TEE di pelayan. Kunci penyahsulitan diuruskan oleh perkhidmatan pengurusan kunci yang turut ditempatkan dalam TEE.
Pihak luar boleh menyemak log ketelusan awam untuk mengetahui beban kerja yang dibenarkan oleh dasar berkenaan. Kertas itu pertama kali diserahkan kepada arXiv pada 25 September dan dikemas kini pada 30 September 2026. Dakwaan peningkatan prestasinya datang daripada penyelidik sistem tersebut, bukannya penilaian bebas terhadap semua kemungkinan penggunaan.
Sumber: Toward provably private learning from federated data — arXiv:2609.31494.
Maksud privasi berbeza dalam latihan AI
Sebagai latar konsep, penerangan NIST tentang differential privacy menjelaskan bahawa hasil analisis sepatutnya hampir sama sama ada data seseorang disertakan atau tidak. Perlindungan ini dinyatakan secara matematik; membuang nama daripada jadual sahaja tidak memberikan jaminan setara.
Salah satu pendekatannya ialah menambah hingar rawak yang ditentukur kepada pengiraan. Tahap perlindungan berkaitan dengan parameter yang sering disebut bajet privasi. Hingar tambahan boleh mengurangkan kegunaan hasil, maka ketepatan dan privasi perlu dinilai bersama.
Sebagai contoh rekaan editorial, pasukan aplikasi kampus mungkin mahu mengetahui corak penggunaan keseluruhan tanpa menonjolkan tabiat seorang pelajar. Soalan reka bentuknya ialah berapa banyak maklumat individu masih boleh dipelajari daripada hasil yang dikeluarkan.
Sumber: Differential Privacy for Privacy-Preserving Data Analysis: An Introduction to our Blog Series — NIST.
Kod terbuka membantu pemeriksaan
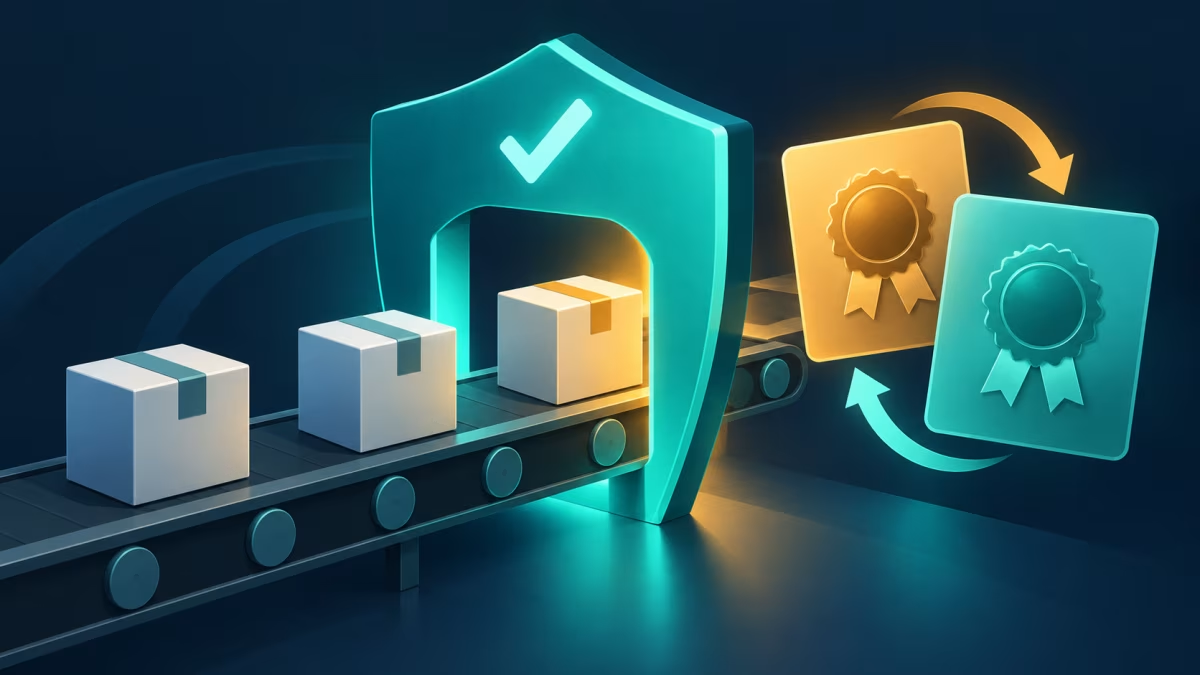
Repositori Confidential Federated Compute menyediakan komponen yang boleh diperiksa secara awam dan bergantung pada Project Oak. Dokumentasinya menerangkan pengesahan jarak jauh, iaitu cara komponen membuktikan kod yang sedang dijalankan sebelum memperoleh akses kepada kunci mengikut dasar.
Dokumentasi itu turut menerangkan binaan boleh dihasilkan semula: kod sumber yang sama menghasilkan artifak binari yang serupa, supaya hubungan antara sumber dan program boleh diperiksa. Repositori tersebut menyatakan bahawa ia bukan produk Google yang disokong secara rasmi.
Google juga mengakui batas perkakasan TEE semasa dan keperluan penyelidikan lanjut terhadap pemerhatian saluran sisi. Oleh itu, istilah boleh diaudit tidak patut dibaca sebagai jaminan bahawa setiap risiko pelaksanaan sudah diselesaikan.
Sumber: Confidential Federated Compute — TEE-hosted binaries for verifiable server-side computation; Toward provably private learning from federated data — Google Research.
Cadangan editorial untuk pembaca Malaysia
Untuk pelajar atau pembangun tempatan, jadikan perkembangan ini latihan mereka bentuk aliran data. Pilih contoh rekaan seperti aplikasi maklum balas kampus. Lukis perjalanan maklumat daripada telefon kepada pemprosesan dan laporan akhir, kemudian tandakan setiap tempat data boleh dibaca.
Bina prototaip menggunakan data sintetik sahaja. Asingkan komponen penerimaan data, pengurusan akses dan penghasilan statistik. Catat perkara yang demonstrasi itu benar-benar buktikan; simulasi kawalan akses tidak membuktikan perlindungan perkakasan TEE atau jaminan matematik privasi.
Bagi pasukan yang menilai pembekal AI, sediakan soalan tentang program yang dibenarkan mengakses data, tempoh penyimpanan, bukti pelaksanaan dan proses perubahan dasar. Minta penerangan yang boleh diuji dalam skop projek sendiri.
Untuk portfolio, sertakan rajah aliran, andaian ancaman dan keputusan ujian bersama kod. Terangkan juga perkara yang masih belum diuji. Cadangan ini ialah latihan editorial untuk membina kemahiran menilai sistem, bukan arahan memasang infrastruktur Google atau menggunakan data pelanggan sebenar.
Rujukan
- Toward provably private learning from federated data — Google Research — 2026-10-02
- Toward provably private learning from federated data — arXiv:2609.31494 — 2026-09-25
- Confidential Federated Compute — TEE-hosted binaries for verifiable server-side computation
- Differential Privacy for Privacy-Preserving Data Analysis: An Introduction to our Blog Series — NIST — 2020-07-27
Disediakan secara automatik dengan bantuan AI berdasarkan sumber yang dipautkan. Semakan sumber: 2026-10-06. Gambar utama ialah ilustrasi janaan AI, bukan foto peristiwa sebenar.
Kumpulan perkongsian peluang kerjaya dalam bidang Teknologi Maklumat(ICT) di Malaysia.