- Algeria
- Bahamas
- Bahrain
- Belarus
- Belgium
- Belize
- Benin
- Bermuda
- Bhutan
- Bolivia
- Bonaire, Sint Eustatius, and Saba
- Botswana
- Bouvet Island
- Brazil
- British Indian Ocean Territory
- British Virgin Islands
- Brunei
- Bulgaria
- Burkina Faso
- Burundi
- Cambodia
- Cameroon
- Canada
- Cape Verde
- Cayman Islands
- Central African Republic
- Chad
- Chile
- China
- Christmas Island
- Cocos [Keeling] Islands
- Colombia
- Comoros
- Cook Islands
- Costa Rica
- Croatia
- Cuba
- Curaçao
- Cyprus
- Czech Republic
- Congo - Kinshasa
- Denmark
- Djibouti
- Dominica
- Dominican Republic
- Timor-Leste
- Ecuador
- Egypt
- El Salvador
- Equatorial Guinea
- Eritrea
- Estonia
- Ethiopia
- Falkland Islands
- Faroe Islands
- Fiji
- Finland
- France
- French Guiana
- French Polynesia
- French Southern Territories
- Gabon
- Gambia
- Georgia
- Germany
- Ghana
- Gibraltar
- Greece
- Greenland
- Grenada
- Guadeloupe
- Guam
- Guatemala
- Guernsey
- Guinea
- Guinea-Bissau
- Guyana
- Haiti
- Heard Island and McDonald Islands
- Honduras
- Hong Kong SAR China
- Hungary
- Iceland
- India
- Indonesia
- Iran
- Iraq
- Ireland
- Isle of Man
- Israel
- Italy
- Côte d’Ivoire
- Jamaica
- Japan
- Jersey
- Jordan
- Kazakhstan
- Kenya
- Kiribati
- Kosovo
- Kuwait
- Kyrgyzstan
- Laos
- Latvia
- Lebanon
- Lesotho
- Liberia
- Libya
- Liechtenstein
- Lithuania
- Luxembourg
- Macau SAR China
- Macedonia
- Madagascar
- Malawi
- Malaysia
- Maldives
- Mali
- Malta
- Marshall Islands
- Martinique
- Mauritania
- Mauritius
- Mayotte
- Mexico
- Micronesia
- Moldova
- Monaco
- Mongolia
- Montenegro
- Montserrat
- Morocco
- Mozambique
- Myanmar [Burma]
- Namibia
- Nauru
- Nepal
- Netherlands
- New Caledonia
- New Zealand
- Nicaragua
- Niger
- Nigeria
- Niue
- Norfolk Island
- North Korea
- Northern Mariana Islands
- Norway
- Oman
- Pakistan
- Palau
- Palestinian Territories
- Panama
- Papua New Guinea
- Paraguay
- Peru
- Philippines
- Pitcairn Islands
- Poland
- Portugal
- Puerto Rico
- Qatar
- Congo - Brazzaville
- Réunion
- Romania
- Russia
- Rwanda
- Saint Barthélemy
- Saint Helena
- Saint Kitts and Nevis
- Saint Lucia
- Saint Martin
- Saint Pierre and Miquelon
- Saint Vincent and the Grenadines
- Samoa
- San Marino
- São Tomé and Príncipe
- Saudi Arabia
- Senegal
- Serbia
- Serbia and Montenegro
- Seychelles
- Sierra Leone
- Singapore
- Sint Maarten
- Slovakia
- Slovenia
- Solomon Islands
- Somalia
- South Africa
- South Georgia and the South Sandwich Islands
- South Korea
- South Sudan
- Spain
- Sri Lanka
- Sudan
- Suriname
- Svalbard and Jan Mayen
- Swaziland
- Sweden
- Switzerland
- Syria
- Taiwan
- Tajikistan
- Tanzania
- Thailand
- Togo
- Tokelau
- Tonga
- Trinidad and Tobago
- Tunisia
- Turkey
- Turkmenistan
- Turks and Caicos Islands
- Tuvalu
- U.S. Virgin Islands
- Uganda
- Ukraine
- United Kingdom
- United States
- U.S. Minor Outlying Islands
- Uruguay
- Uzbekistan
- Vanuatu
- Vatican City
- Venezuela
- Vietnam
- Wallis and Futuna
- Western Sahara
- Yemen
- Zambia
- Zimbabwe
 by Ts Hasnan
- 25, Sep 2026
NVIDIA Perinci NVCRE: Uji Kluster GPU Sebelum Beban Kerja AI Bermula
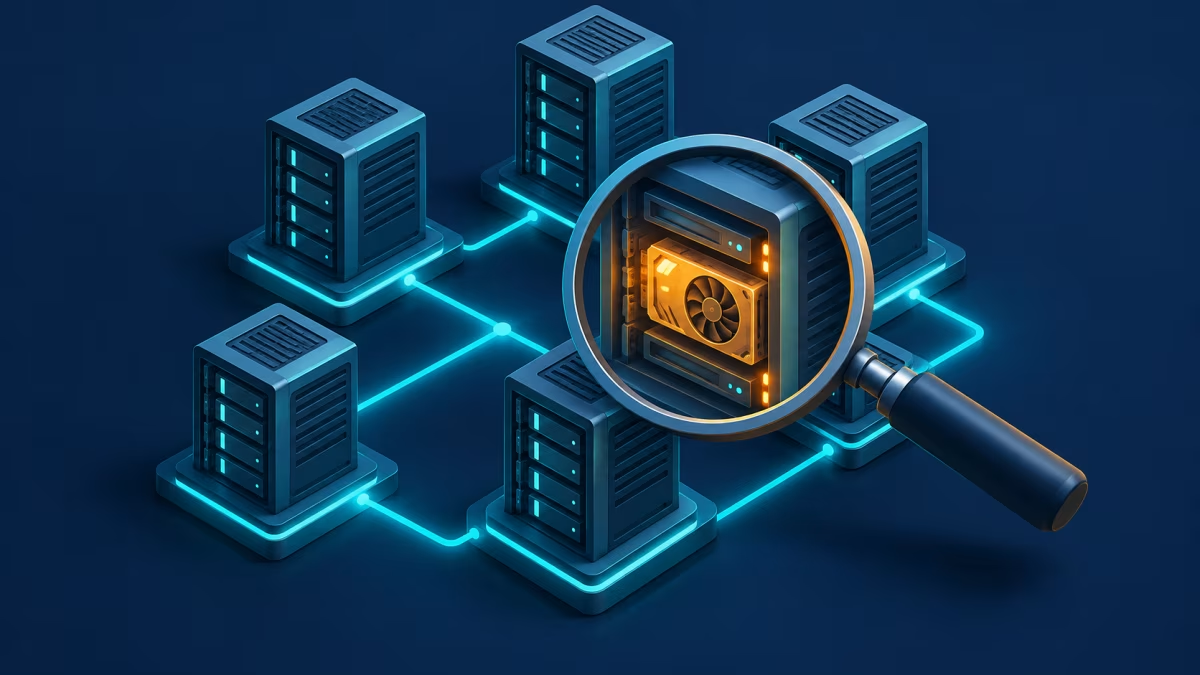
Sebelum menyerahkan kluster GPU kepada pasukan AI, apakah bukti bahawa semua pelayan benar-benar mampu bekerja bersama? Penerangan teknikal NVIDIA pada 23 September 2026 mengetengahkan NVIDIA Cluster Readiness Engine, atau NVCRE, untuk menguji persoalan tersebut melalui beban kerja sebenar.
Bagi pembaca IT Jobs Malaysia, perkembangan ini membuka ruang memahami kerja di belakang operasi AI: menyediakan ujian, membaca bukti kegagalan dan menentukan sama ada infrastruktur sudah sesuai digunakan. Nilainya melangkaui kebolehan memasang perisian semata-mata.
Perkembangan terkini: pengujian sebelum penggunaan sebenar
Dalam penerbitan itu, NVIDIA menerangkan NVCRE sebagai pengawal Kubernetes sumber terbuka yang menjalankan beban kerja teragih pada kumpulan nod mengikut topologi. Nod ialah mesin dalam kluster, manakala topologi merujuk susunan hubungan antara mesin tersebut. Alat ini mengukur hasil ujian dan melaporkan nod yang gagal.
Menurut NVIDIA, pemeriksaan kesihatan komponen boleh kelihatan baik walaupun masalah hanya muncul ketika kluster menanggung beban bersama. Penerbitan tersebut ialah penerangan teknikal bertarikh baharu; ia tidak wajar dianggap bukti bahawa projek ini baru pertama kali tersedia pada hari itu. Keupayaan yang dihuraikan juga merupakan penerangan pembangun, bukannya penilaian bebas prestasi.
Sumber: Validate GPU Cluster Readiness Before AI Workloads Land.
Apakah yang sebenarnya diuruskan oleh alat ini?
Repositori rasmi menyenaraikan ujian komunikasi NCCL dan beban latihan berbilang nod dalam katalog NVCRE. Alat ini turut menyediakan pengelompokan nod berdasarkan topologi, pengasingan kerosakan secara adaptif serta laporan kegagalan berserta sebab bagi setiap nod yang dikenal pasti.
Aliran kerjanya menggunakan tiga lapisan: Certification menetapkan pengujian, Workflow mengurus kategori, dan Job menjalankan kerja berkaitan. Pengguna juga boleh menggunakan WorkloadRun untuk beban kerja tersendiri. Struktur ini menyediakan rekod yang boleh diperiksa apabila keputusan ujian perlu disiasat oleh pasukan operasi.
Sasaran yang dinyatakan ialah pasukan platform dan infrastruktur yang menyediakan, mengesahkan atau menjual semula kapasiti kluster GPU. Oleh itu, pembaca perlu menilai kesesuaiannya berdasarkan tanggungjawab operasi mereka.
Sumber: NVIDIA Cluster Readiness Engine (NVCRE) — Repositori rasmi.
Membaca keputusan tanpa membuat kesimpulan berlebihan
Panduan rasmi Interpret Results membezakan ringkasan keseluruhan, keputusan mengikut kategori, kumpulan yang gagal dan pecahan keputusan setiap nod. Status InProgress bermaksud ujian masih berjalan. Status Passed pula merujuk pemenuhan ambang bagi semua kategori pada semua kumpulan nod dalam ujian berkenaan.
Dokumentasi turut menerangkan ukuran goodput sebagai bahagian masa ketika kerja menghasilkan kemajuan berguna. Ini membantu pembaca melihat lebih daripada sekadar sama ada proses berjaya dimulakan.
Ada batas penting pada bukti diagnostik: petikan log kegagalan mewakili satu pod terpilih, bukannya gabungan semua pod yang gagal. Pod ialah unit pelaksanaan aplikasi dalam Kubernetes. Maka, petikan tersebut perlu dibaca bersama konteks ujian; ia bukan gambaran lengkap seluruh insiden.
Sumber: Interpret Results — NVIDIA Cluster Readiness Engine.
Pengesahan kesiapsiagaan mempunyai skop tertentu
Repositori NVCRE menjelaskan bahawa alat ini bukan sistem pemantauan berterusan, penjadual umum atau papan kedudukan perkakasan. Pemerhatian nod berlaku ketika beban ujiannya berjalan, dan ukuran digunakan untuk mencari masalah.
NVCRE juga merekodkan kegagalan tanpa mengkuarantin atau mengubah nod secara automatik. Tindakan pemulihan diserahkan kepada platform pengguna. Perbezaan ini perlu difahami sebelum pasukan menyusun tanggungjawab antara pengujian, pemantauan dan pengendalian insiden.
Sumber: NVIDIA Cluster Readiness Engine (NVCRE) — Repositori rasmi.
Cadangan editorial untuk pasukan dan pelajar di Malaysia
Cadangan berikut ialah pandangan editorial, bukan laporan penggunaan NVCRE oleh organisasi Malaysia. Untuk pasukan tempatan yang sedang menilai infrastruktur AI, mulakan dengan satu soalan penerimaan yang jelas: apakah beban kerja yang mesti berjaya sebelum kapasiti ini diserahkan kepada pengguna? Nyatakan ukuran, tempoh dan pihak yang menyemak keputusan.
Sebagai contoh latihan rekaan, sebuah makmal universiti boleh menyediakan borang keputusan yang merekodkan mesin terlibat, konfigurasi, masa ujian dan pemerhatian. Jika dua percubaan memberikan hasil berbeza, pelajar perlu menerangkan perkara yang berubah sebelum menyimpulkan bahawa perkakasan rosak.
Bagi organisasi yang menyewa kapasiti, kami mencadangkan agar pasukan meminta penjelasan tentang skop ujian penyedia. Adakah laporan meliputi mesin yang akan digunakan, dan adakah konfigurasi ujian sepadan dengan rancangan projek? Soalan ini boleh dijadikan bahan perbincangan teknikal sebelum keputusan operasi dibuat.
Untuk portfolio kerjaya, cuba hasilkan contoh laporan penerimaan infrastruktur yang ringkas. Bezakan pemerhatian, hipotesis dan tindakan susulan. Nyatakan juga perkara yang belum diuji. Jika tiada akses GPU, sediakan pelan ujian dan contoh laporan berlabel simulasi; jangan persembahkannya sebagai keputusan eksperimen sebenar.
Utamakan kebolehan menerangkan bukti. Laporan yang menunjukkan mengapa sesuatu keputusan diterima, ditolak atau memerlukan ujian tambahan lebih berguna sebagai bahan perbincangan berbanding tangkap layar kejayaan tanpa konteks.
Rujukan
- Validate GPU Cluster Readiness Before AI Workloads Land — 2026-09-23
- NVIDIA Cluster Readiness Engine (NVCRE) — Repositori rasmi
- Interpret Results — NVIDIA Cluster Readiness Engine
Disediakan secara automatik dengan bantuan AI berdasarkan sumber yang dipautkan. Semakan sumber: 2026-09-25. Gambar utama ialah ilustrasi janaan AI, bukan foto peristiwa sebenar.
Kumpulan perkongsian peluang kerjaya dalam bidang Teknologi Maklumat(ICT) di Malaysia.